

엔비디아 AI 데이 서울 2026에서 발표된 NVLink 퓨전 협약의 핵심 기술을 정리합니다. 리벨 R200 NPU와 엔비디아 MGX 규격이 어떤 역할을 맡는지 확인해 보세요.
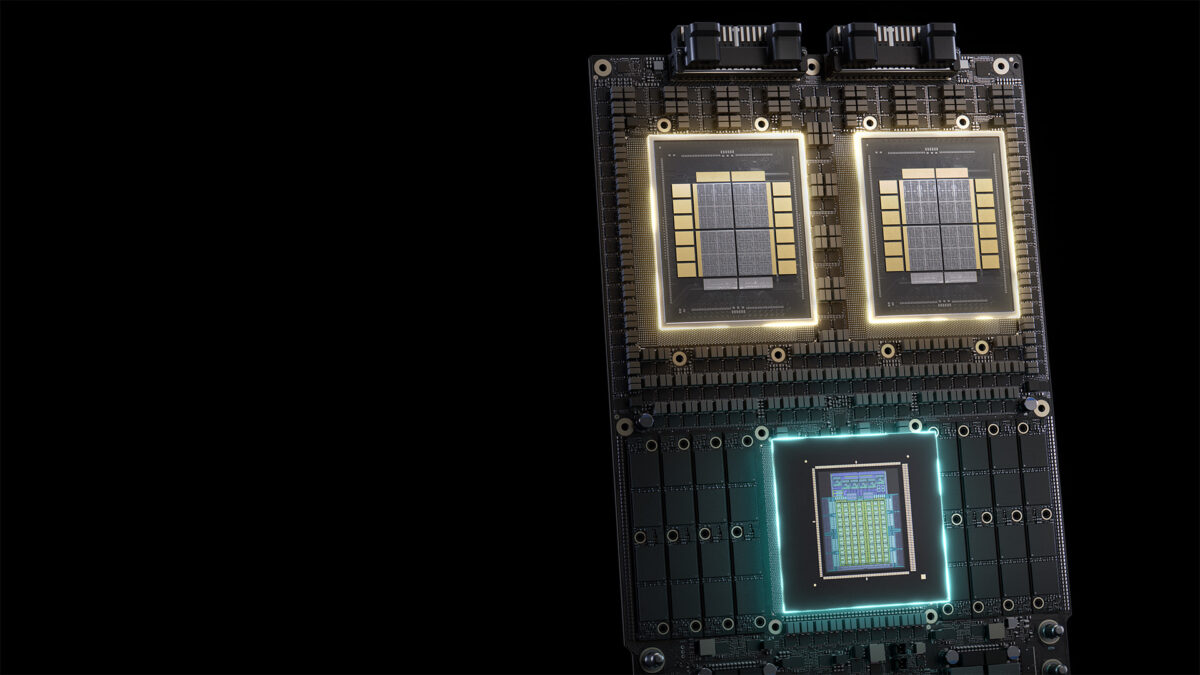
이미지 출처 : 엔비디아
서울 코엑스에서 열린 엔비디아 AI 데이 서울 2026 현장에서 SK텔레콤, 리벨리온, 엔비디아 3사가 NVLink 퓨전 기반의 차세대 시스템 개발을 위한 업무협약을 체결했습니다. 이번 협약의 본질은 서로 다른 제조사의 AI 반도체를 단일 시스템 내부에서 매끄럽게 작동하도록 연결하는 데 있습니다. 그래픽처리장치(GPU) 시장을 주도하는 엔비디아의 생태계에 국내 신경망처리장치(NPU) 팹리스인 리벨리온의 차세대 칩이 공식적으로 결합되는 구조입니다.
그동안 AI 데이터센터는 엔비디아 GPU를 중심으로 단일 칩 아키텍처를 확장하거나 완전히 분리된 별도 서버 랙을 구축하는 방식을 주로 사용해 왔습니다. 하지만 연산 비용과 전력 효율 문제가 점차 심화되면서 서로 다른 반도체의 장점을 융합하는 시도가 이어지고 있습니다. 이번 3자 협약은 바로 이러한 기술적 병목을 해결하기 위해 기획된 실질적인 개발 협력입니다.
NVLink 퓨전 협약이 목표로 하는 통합 시스템의 본질
이번 협약에서 세 회사가 공동으로 개발하려는 시스템은 이종 반도체 통합 연산 환경입니다. 기존에는 엔비디아 플랫폼 내부에서 자체 GPU끼리 통신할 때 초고속 인터커넥트 기술인 NVLink를 사용해 데이터 병목을 최소화했습니다. NVLink 퓨전은 이 연결 통로를 엔비디아 외의 다른 프로세서로 확장하여 서로 다른 칩이 마치 하나의 거대한 프로세서처럼 통신할 수 있게 만듭니다.
통합 시스템 개발이 완성되면 고성능 범용 연산에 강한 엔비디아 프로세서와 특정 추론 연산에 특화된 가속기가 메모리와 데이터를 지연 없이 주고받게 됩니다. 이번 협력은 단순한 공동 마케팅이나 기술 제휴 수준을 넘어 실질적인 하드웨어 상호 운용성을 검증하는 데 방점이 찍혀 있습니다.
차세대 NPU 리벨 R200이 담당하는 하드웨어적 위치
통합 시스템에서 핵심적인 한 축을 담당하는 반도체는 리벨리온이 개발 중인 차세대 NPU 리벨 R200입니다. 리벨 R200은 대규모 언어모델(LLM)과 최신 신경망 알고리즘 추론을 고효율로 처리하기 위해 설계된 전용 칩입니다. 협약 내용에 따르면 리벨리온은 리벨 R200을 NVLink 퓨전 인터페이스를 통해 엔비디아 컴퓨팅 플랫폼에 직접 연결합니다.
통상 NPU가 독립형 PCIe 카드로 장착될 때는 호스트 시스템과의 데이터 전송 속도가 제한되는 한계가 존재했습니다. 그러나 리벨 R200이 엔비디아의 인터커넥트 규격을 활용하게 되면서 칩 간 대역폭 병목을 해소할 수 있는 물리적 기반을 확보하게 됩니다. 엔비디아 공식 뉴스룸 발표에 따르면 리벨 R200 기반 시스템은 2028년 배치 준비를 마칠 것으로 예상되고 있습니다. 이는 양산 확정이나 즉각적인 상용 도입이라기보다는 하드웨어 완성 및 데이터센터 배치 준비 완료를 목표로 한 일정입니다.
엔비디아 MGX 랙 아키텍처의 도입 목적과 효과
이번 협업에서 하드웨어 인프라의 표준 프레임워크 역할을 맡는 것은 엔비디아 MGX 랙 아키텍처입니다. MGX는 서버 제조사와 데이터센터 운영자가 다양한 CPU, GPU, DPU, 그리고 이종 가속기를 모듈식으로 자유롭게 조합할 수 있도록 규격화한 오픈 서버 아키텍처입니다.
MGX 규격을 적용함으로써 리벨 R200과 엔비디아 플랫폼은 규격화된 서버 섀시와 전원, 냉각 인프라 안에서 안정적으로 통합됩니다. 서버 설계를 처음부터 다시 진행할 필요 없이 검증된 랙 아키텍처 내부에서 시스템을 구현할 수 있어 데이터센터 적용 시 발생할 수 있는 호환성 검증 부담을 크게 덜어줍니다.
표준 규격 위에서 구현되는 하드웨어 구조는 향후 SK텔레콤의 AI 데이터센터 인프라에 테스트베드를 구축하고 실증을 진행할 때 신속하고 체계적인 검증을 가능하게 만드는 토대가 됩니다.
AI 추론 단계의 기능 분리와 인프라 검증 계획
3사가 구상하는 소프트웨어 및 워크로드 분담 방식은 AI 추론 과정을 둘로 쪼개는 분리형 구조에 맞춰져 있습니다. 사용자의 입력을 해석하고 맥락을 파악하는 질문 분석 단계인 프리필(Prefill)은 대규모 병렬 연산 성능이 뛰어난 엔비디아 GPU가 처리합니다. 반면 실제 텍스트나 데이터를 순차적으로 생성해 나가는 답변 생성 단계인 디코드(Decode)는 전력 대비 효율이 우수한 리벨리온의 리벨 R200 NPU가 전담하는 형태입니다.
이러한 역할 분담은 추론 처리량을 극대화하고 데이터센터의 운영 전력 부담을 낮추려는 구상에서 출발했습니다. 다만 현시점의 공식 발표 자료에는 구체적인 처리 속도 향상 수치나 전력 절감률 같은 정량 데이터는 공개되지 않았습니다. 어디까지나 아키텍처 차원의 설계 목표로 이해하는 것이 정확합니다.
SK텔레콤은 이 통합 시스템을 자사 AI 데이터센터에서 직접 테스트하며 성능과 하드웨어 안정성을 정밀 검증할 예정입니다. 검증 결과에 따라 독자 거대언어모델인 A.X K2와 대국민 서비스인 모두의 AI 등에 활용하는 방안을 다각도로 검토하고 있습니다. 이는 확정된 도입이 아닌 실증 단계의 검토 과정입니다.
자주 묻는 질문
NVLink 퓨전이란 무엇이며 기존 연결 기술과 어떻게 다른가요?
NVLink 퓨전은 엔비디아의 고속 인터커넥트 기술인 NVLink를 타 제조사의 프로세서나 가속기까지 연결할 수 있도록 개방·확장한 하드웨어 연결 규격입니다. 기존 엔비디아 칩셋 간의 연결을 넘어 리벨 R200과 같은 타사 NPU를 단일 고속 버스로 묶어 대역폭 병목을 해소합니다.
리벨리온의 리벨 R200은 시스템에서 구체적으로 어떤 역할을 맡나요?
리벨 R200은 AI 추론 과정 중 대규모 언어모델의 답변을 순차적으로 생성해내는 디코드(Decode) 연산을 전담하도록 설계되었습니다. NVLink 퓨전으로 엔비디아 플랫폼에 직결되어 고효율 전용 추론 처리를 수행합니다.
엔비디아 MGX 아키텍처는 왜 필요한가요?
엔비디아 MGX는 이종 반도체와 모듈형 하드웨어를 표준화된 서버 랙 규격 안에서 통합할 수 있도록 돕는 아키텍처입니다. 전원, 냉각, 물리적 슬롯 규격을 통일하여 리벨 R200과 엔비디아 프로세서를 하나의 서버 랙에서 안정적으로 구현하고 데이터센터에 배치하기 쉽게 만들어 줍니다.