

RTX Spark 노트북은 Grace CPU와 블랙웰 GPU를 통합해 기존 외장 그래픽 노트북과 근본적으로 다른 메모리 및 버스 구조를 갖췄습니다. Arm 기반 에뮬레이션 구동 원리와 아키텍처 차이를 상세히 살펴봅니다.
Arm 기반 슈퍼칩으로 전환된 RTX Spark 노트북 구조
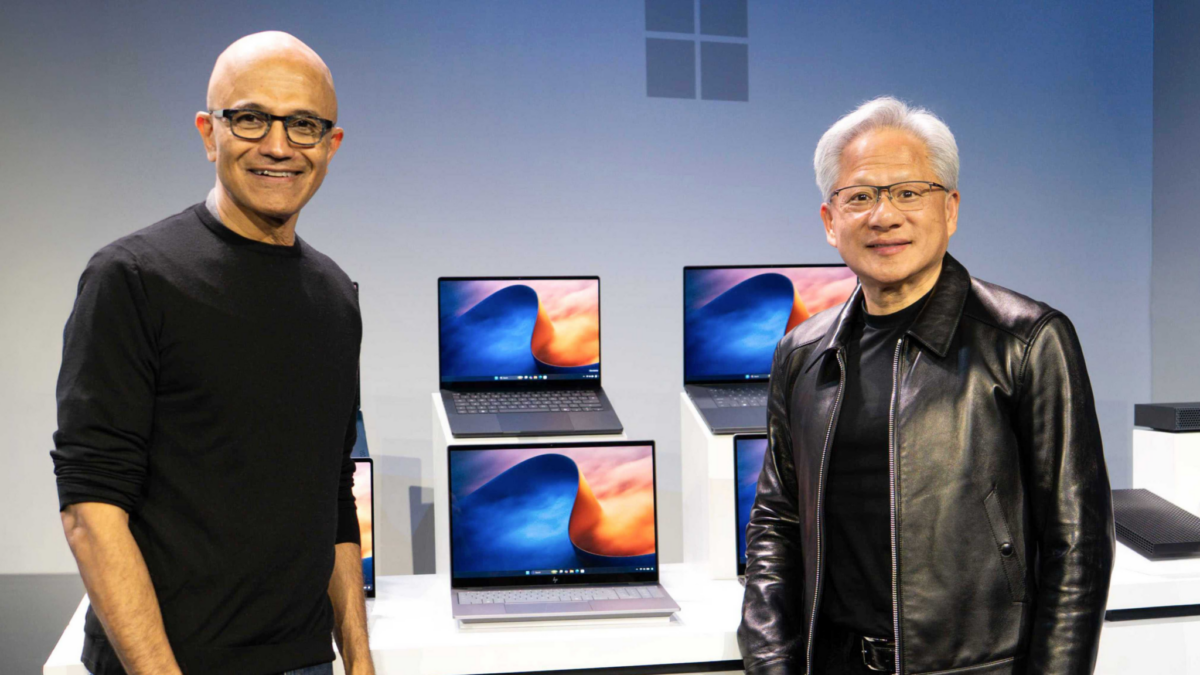
이미지 출처 : 엔비디아
엔비디아가 미디어텍과 협력하여 선보인 RTX Spark 노트북은 단순한 세대 교체형 모바일 그래픽카드가 아닙니다. 기존 모바일 고성능 PC 시장을 지탱하던 인텔이나 AMD의 x86 프로세서 및 별도 분리된 모바일 지포스 외장 그래픽카드 조합과 달리, CPU와 GPU를 하나의 패키지 안에 집약한 슈퍼칩 형태를 취하고 있습니다. 발표된 사양에 따르면 최대 20코어의 Grace CPU와 최대 6,144개 CUDA 코어를 지닌 블랙웰(Blackwell) 아키텍처 기반 RTX GPU가 결합되어 동작합니다.
가장 근본적인 하드웨어 아키텍처의 차이는 연산 장치가 사용하는 명령어 세트 구조(ISA)에 있습니다. 전통적인 윈도우 노트북이 복잡한 x86-64 명령어 체계를 따랐다면, RTX Spark는 고효율 저전력 연산에 특화된 Arm 아키텍처를 기반으로 설계되었습니다. 이에 따라 시스템의 뼈대를 이루는 마더보드 회로와 데이터 전송 통로, 칩셋 간 통신 메커니즘까지 완전히 재설계되었습니다.
분리형 외장 GPU 노트북과 RTX Spark의 핵심 구조 비교
기존 고성능 게이밍 및 워크스테이션 노트북은 x86 호스트 CPU와 별도의 엔비디아 외장 그래픽 칩셋(dGPU)이 PCIe(PCI Express) 인터페이스 버스를 통해 물리적으로 연결되어 있었습니다. 이 전통적 구조에서는 그래픽 연산이나 AI 모델 연산을 수행할 때마다 시스템 메인 메모리(DDR5 등)에서 PCIe 슬롯을 거쳐 외장 GPU의 전용 그래픽 메모리(GDDR VRAM)로 데이터를 복사해 넘겨주는 과정이 필수적이었습니다.
반면 RTX Spark 플랫폼은 Grace CPU와 블랙웰 GPU를 초고대역폭 인터커넥트인 NVLink-C2C(Chip-to-Chip) 기술로 연결합니다. PCIe 버스 대비 압도적으로 지연 시간이 짧고 대역폭이 넓은 전용 상호 연결망을 사용함으로써, 프로세서와 그래픽 코어 사이의 데이터 전송 병목 현상을 획기적으로 줄인 형태입니다. 두 연산 유닛이 마치 단일 다이 내부에서 소통하듯 긴밀하게 묶여 있습니다.
| 비교 항목 | 기존 x86 외장 그래픽 노트북 | RTX Spark 노트북 |
|---|---|---|
| CPU 아키텍처 | x86-64 (Intel Core / AMD Ryzen) | Arm v9 기반 (Grace CPU, 최대 20코어) |
| GPU 연결 방식 | PCIe 버스 (외부 레인 경유) | NVLink-C2C 초고속 인터커넥트 |
| 메모리 체계 | 시스템 RAM과 GPU VRAM 분리 | 최대 128GB 통합 메모리(Unified Memory) |
| 기본 구동 OS | 표준 x86 윈도우 | 윈도우 온 Arm (Windows on Arm) |
| 레거시 앱 처리 | x86 네이티브 직접 실행 | 마이크로소프트 Prism 에뮬레이션 거침 |
VRAM 한계를 뛰어넘는 최대 128GB 통합 메모리 아키텍처
기존 모바일 지포스 외장 그래픽을 장착한 노트북 사용자들을 가장 곤란하게 만들었던 제약은 바로 VRAM 용량이었습니다. 시스템 메모리를 64GB나 128GB로 증설하더라도, 모바일 외장 GPU에 물리적으로 납땜된 VRAM이 8GB나 16GB에 불과하다면 그래픽 칩셋이 직접 다룰 수 있는 단일 데이터셋의 크기는 16GB를 넘지 못했습니다. 대규모 3D 모델링 장면이나 수백억 개 파라미터를 가진 거대 언어 모델(LLM)을 올릴 때 즉각적인 메모리 부족(OOM) 오류가 발생했던 원인입니다.
RTX Spark 노트북은 CPU와 GPU가 최대 128GB 통합 메모리 풀을 완벽하게 공유합니다. 애플 실리콘의 통합 메모리 구조와 유사하게, 한 번 적재된 데이터는 별도의 메모리 복사 단계 없이 CPU와 GPU가 동일한 주소 공간을 통해 즉시 접근할 수 있습니다. 엔비디아 발표 기준으로 최대 1,200억 파라미터(120B) 규모의 AI 모델 로컬 추론이나 90GB를 상회하는 방대한 3D 그래픽 씬 렌더링이 노트북 단일 기기에서 가능해지는 물리적 근거가 바로 이 통합 메모리 풀에 있습니다.
윈도우 온 Arm 환경과 Prism 에뮬레이션 구동 원리
소프트웨어 실행 관점에서 RTX Spark 노트북의 동작 방식은 전통적인 x86 PC와 확연히 갈립니다. 이 기기는 윈도우 온 Arm(Windows on Arm) 운영체제에서 기본 구동됩니다. 즉, Arm 네이티브로 컴파일된 프로그램이나 엔비디아 CUDA 플랫폼 기반 AI 프레임워크는 Grace CPU와 블랙웰 텐서 코어에서 최고 속도로 네이티브 실행됩니다.
그러나 일반 소비자가 주로 즐기는 스팀, 에픽게임즈의 대다수 PC 패키지 게임과 레거시 x86 소프트웨어는 여전히 인텔/AMD 명령어 체계에 맞춰져 있습니다. 이를 해결하기 위해 마이크로소프트의 Prism 에뮬레이션 엔진이 개입합니다. Prism은 x86 명령어를 실시간으로 Arm 명령어로 변환(JIT 컴파일)하여 프로세서에 전달합니다. 따라서 별도의 x86 바이너리 수정 없이도 일반적인 윈도우 프로그램과 게임을 구동할 수 있습니다.
게임 및 전문 소프트웨어 구동 시 체감되는 장단점
구조가 바뀜에 따라 사용자가 체감하는 환경에도 명확한 명암이 존재합니다. CUDA 라이브러리를 적극적으로 활용하는 로컬 AI 추론, 파이토치(PyTorch) 환경, 3D 렌더링 파이프라인에서는 128GB 통합 메모리와 6,144개 CUDA 코어의 시너지가 극대화됩니다. VRAM 용량 압박 없이 데스크톱 워크스테이션급 대형 프로젝트를 열람하고 렌더링할 수 있다는 점은 기존 모바일 외장 GPU 랩톱이 제공하지 못했던 차별점입니다.
반면 순수 게임 플레이와 상용 레거시 플러그인 환경에서는 주의가 필요합니다. Prism 에뮬레이션 성능이 비약적으로 발전했다고 하더라도, 명령어 변환 단계에서 필연적으로 일정 수준의 연산 오버헤드가 발생합니다. 더욱이 안티치트(커널 드라이버 기반 보안 솔루션)가 탑재된 온라인 멀티플레이어 게임이나, 특정 하드웨어 전용 드라이버를 요구하는 음향·영상 하드웨어 플러그인은 Arm 윈도우 환경에서 실행 자체가 차단되거나 오작동할 여지가 있습니다. 즉, 모든 게임 프레임을 네이티브로 뽑아내던 기존 외장 GPU 게이밍 랩톱과 동일한 호환성을 기대하기는 어렵습니다.
자주 묻는 질문
RTX Spark 노트북에서 기존 스팀 게임을 그대로 설치하고 실행할 수 있나요?
윈도우 온 Arm에 내장된 마이크로소프트 Prism 에뮬레이터를 통해 일반적인 x86 기반 패키지 게임은 설치 및 구동이 가능합니다. 다만 커널 레벨 안티치트 프로그램을 사용하는 일부 온라인 게임은 실행이 제한될 수 있습니다.
기존 외장 그래픽 랩톱의 VRAM 부족 문제와 RTX Spark의 차이는 무엇인가요?
기존 랩톱은 외장 GPU 전용 VRAM(통상 8GB에서 16GB)이 정해져 있어 대용량 AI 모델이나 3D 작업 시 용량 병목이 발생했습니다. RTX Spark는 CPU와 GPU가 최대 128GB의 단일 메모리 풀을 공유하므로 메모리 부족 없이 방대한 데이터를 다룰 수 있습니다.
엔비디아가 발표한 1페타플롭 AI 성능이 게임 프레임에도 그대로 반영되나요?
그렇지 않습니다. 최대 1페타플롭 수치는 초저정밀도인 FP4 기반 텐서 AI 연산 처리량을 기준으로 엔비디아가 제시한 수치입니다. 이는 로컬 LLM 및 생성형 AI 모델 추론 능력을 나타내는 지표이며 게임 그래픽 렌더링 프레임과는 직접적인 비례 관계가 아닙니다.